软件之后:AI 时代的协作、生产与价值分配

过去做一个像样的软件,几乎必须先有一家公司:融资、招工程师、设计师、销售和市场。公司拥有代码,支付工资,承担风险,也拿走产品成功后的大部分收益。这个模式非常成功,也塑造了我们今天几乎所有的软件产业。SaaS 如此,工具、协议、组件、客户端也大致如此。
但 AI 正在拆掉其中一个最基本的前提。一个人加上 AI,已经可以做出过去小团队才能完成的东西。再往前一步,当越来越多 AI 可以独立理解任务、改代码、测试、研究、设计、营销甚至销售时,真正的问题已经从“怎么招人”变成另一件更难的事:
当生产能力可以分散在无数个人和 AI 手里时,协作、所有权、价值分配应该如何重新组织?
制造软件,不再必然需要先制造一个组织。这不是说公司突然没用了。需要强品牌、强合规、强持续运营的产品,公司往往仍然是最高效的容器。我关心的是另一条开始变得可能的路径:许多彼此独立的人和 AI,能不能为了一个共同的产品临时组织起来,一起完成工作。
这看起来只是生产效率的变化。如果继续往下推,它会触及软件产业更深的一层。
从“我想要这个产品”开始
很多软件项目最早并不是从技术开始的,而是从一句很简单的话开始:“如果有人能把这个做出来,我一定会买。” 在新技术刚出现的时候,这类人尤其常见。他们看见了一个真实的问题,也理解新技术可能怎样解决它,但自己没有足够的时间、技术能力或者风险承担能力去把产品做出来。有的人甚至会说:“你如果做出来,我先买一套。” 或者:“我知道还有十家公司会需要,我可以介绍给你。”
这类人不是传统意义上的投资人,也不完全是销售人员。他们首先贡献了一件极其重要的东西:真实需求。
需求被付钱证明,不是随口一句 idea。
在软件越来越容易制造的时代,这种需求信号可能反而越来越珍贵。AI 可以帮助我们生成无数产品 idea,却无法自动证明这些东西真的值得存在。因此未来的软件生产,也许不应该总从 Idea → 融资 → 招人 → 开发 → 上线以后再寻找客户开始。它可以是另一条路径:
需求 → 承诺 → 协作 → 产品 → 收入
例如,一个项目首先进行 pre-sale。Pre-sale 在这里不是投资。一个人花 100 美元购买未来的软件,他得到的是未来产品以及早期价格优惠,而不是项目股份,也不是未来收益权。但这个购买行为产生了一个很重要的信号:这个需求不是一句随口说出的意见。 他真的愿意为它付钱。
项目因此可以逐渐形成一群 Founding Customers:真正希望这个产品存在的人。其中一部分人还会进一步参与。有人懂这个行业,可以帮助定义需求。有人可以测试 prototype。有人认识未来客户。有人可以帮助销售。还有一些人,会愿意把自己的 AI 资源直接投入进来,让这个产品更快出现。
从 Crowd Funding 到 Crowd Building
过去互联网已经证明,人们可以共同资助一个项目。这就是 crowdfunding。AI 带来了另一个可能性:人们不仅可以共同出钱,还可以共同生产。 这可以称作 Crowd Building。
假设一个用户真的非常希望某个产品出现。今天,他最多可以多付一点预付款,然后等待开发团队工作。未来,他也许可以做另一件事:把自己的 AI Worker 派进去帮助完成项目。他可能已经订阅了 Claude、Codex 或其他 AI 服务。这些 AI 资源通过一个标准接口接入他自己的 Worker Pool。他不需要把钱交给项目负责人,也不需要成为某家公司的员工。他只需要选择:“我愿意把两个 Worker 在未来一周投入这个项目。” 然后这些 Worker 开始领取实际任务:修 bug、写测试、做页面、研究竞品、整理文档、完成 localization。
项目获得的不是资本,而是生产能力。
派出去的是闲置产能和判断,不是把现金交出去。
这和传统投资有一个很根本的区别。传统投资是:我认为这个项目有前景,所以我把钱给项目团队,希望他们把事情做好。Crowd Building 更像:我认为这个项目有前景,所以我把自己的生产资源投入进去,直接帮助它变得更成功。 前者是 capital allocation。后者是 productive capacity allocation。两者都会包含判断、机会成本和风险,但经济行为并不相同。
这里有一个必须先说清的问题:为什么不直接给钱?如果我已经有 200 美元的 Claude 订阅,把 200 美元交给项目方,对方想买什么都行,看起来更灵活。产能相比现金,在形式上是更窄的资源。它之所以仍然成立,是因为两件事现金替代不了。
第一,订阅制留下了大量闲置产能。固定成本已经付过了,派出去的边际成本接近零,对接收方却是全额可用的生产能力。这是 Crowd Building 相对 crowdfunding 很难被现金抹平的经济基础。第二,派进去的不只是算力。操作、选任务、验收,仍然是人在做。贡献的是“判断 + 算力”的捆绑包,现金会把判断剥掉。
也要承认副作用:边际成本接近零,意味着灌水的成本也接近零。Sybil 和刷量在经济上是必然的,不是意外。后面谈 Contribution 时,这个问题会再回来。
为了后面少猜名词,先把几个核心抽象放在桌上:
- Worker:可被调度的生产能力单元,不绑定某一种模型。
- ARC(Agentic Realm Computer):一个人或一个实体控制的计算与生产环境。Worker 从这里长出来。
- DARC:让多个独立 ARC 协同工作的协议。
- Blocklet:带有身份、状态、所有权和经济关系的可组合软件单元。
这些 Worker 要跑在某个地方。我们把这个地方叫 ARC。后面的 Worker Pool、DARC、Darc Factory,都是从 ARC 上长出来的。展望不必把运行时讲得很细,只要记住:没有 ARC,生产能力还是散落在各家订阅和各台电脑里,没法被调度,也没法被一起验收。
Worker 不等于某一种 AI
这里的 Worker 不应该等同于 Claude、Codex 或任何具体模型。AI 技术变化太快。今天最好的模型,几年以后很可能只是普通基础设施。因此更合理的做法,是在 AI 资源之上建立一个标准的 Worker Pool。一个人可以把任何自己拥有和控制的生产资源接进来:Claude、Codex、Gemini、本地模型、GPU、specialized agents、数据和 API,以及未来尚未出现的 AI 系统。
对项目来说,它并不应该关心:“你的 Worker 后面到底是哪家公司提供的模型?” 项目真正关心的是:这个 Worker 能做什么?它获得了什么权限?它领取了什么任务?它产生了什么结果?这个结果是否通过验证?
就像工地不必关心挖掘机的发动机是哪家公司造的,但一定关心机器和操作员有没有资质、这次作业有没有被验收。土挖了多少立方,只是规格明确时才够用。软件贡献的难点,恰恰是任务规格往往并不明确。
于是 AI provider 提供的是 horsepower。ARC 把 horsepower 转变为可以加入生产体系的 Worker。
DARC:让独立的 ARC 一起工作
把分散的 Worker 聚在一起只是第一步。真正难的是让它们不打架、不刷量、能产生可验证的价值。单个 AI agent 能够工作,并不是最难的问题。真正困难的是:几百甚至几千个属于不同人的 Worker,怎样一起完成一个产品?
这需要远远超过传统 agent harness 的机制。如果没有足够强的协调体系,很快就会发生:多个 Worker 同时做重复任务;对同一段代码做互相冲突的修改;不知道哪个结果值得采用;Worker 为了获得 credit 而刷工作量;有人制造问题,再自己修复问题;大量产出看起来完成了,却没有真正价值;外部 Worker 获得了不应该获得的权限。
因此需要一个更宏观的生产协议。我们把它称为 DARC Protocol,可以理解为 Decentralized Autonomous Resource Coordination:一个让彼此独立控制的 ARC 和生产资源能够协同工作的协议。
ARC 可以工作。DARC 让许多 ARC 一起工作。
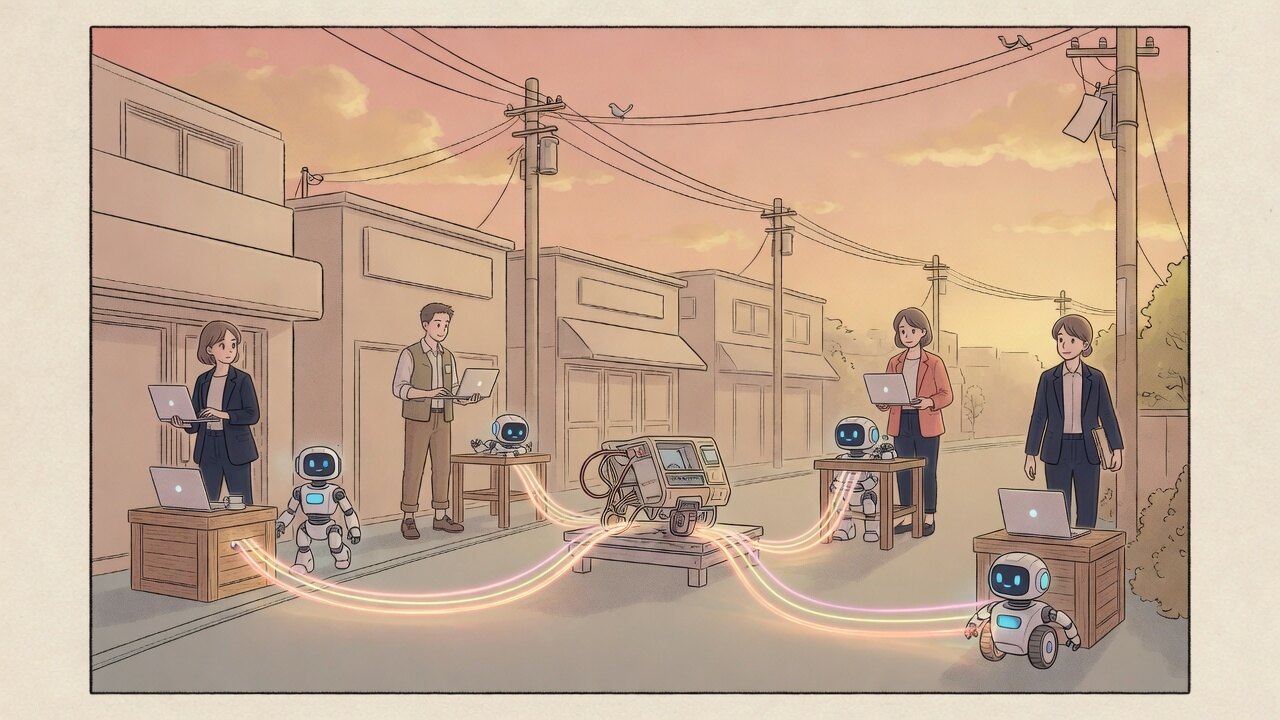
彼此独立的 ARC 连向同一个未完成的产品。
在 DARC 之上,可以运行 Darc Factory。这个名字里有一层 dark factory 的谐音,指工业里那种高度自动化、可以在极少人工干预下持续运行的生产体系。未来的软件工厂也可能逐渐如此。但这里的重点不是“无人化”,更不是把人从生产里请出去。Darc Factory 并不是简单地让大量 AI 自己生成代码。它真正需要解决的是整个生产过程:目标是什么,如何拆任务,哪些 Worker 最合适,给它多少权限,如何并行执行,如何测试,如何 review,哪些结果被采用,哪些需要返工,谁真正做出了贡献。
这是一个生产系统,而不仅仅是一个 agent launcher。安全、权限、作弊和质量控制,会是这个系统的核心工程,而不是附带事项。
Contribution:不能用“烧了多少 AI”来衡量
如果 Crowd Building 真的产生经济收益,那么最难的问题很快就会出现:谁贡献了多少?
最简单的方法当然是按工作量。但这几乎一定是错误的。一个 Worker 消耗了一百万 tokens,不代表它创造了一百万 tokens 的价值。一个人写了五万行代码,也不一定比另一个人提出一句正确的产品建议更有价值。所以:
Resource ≠ Contribution
更合理的路径应该是:
Resource → Work → Accepted Output → Downstream Value → Contribution
例如两个人都花了 200 美元运行 AI。第一个人的 Worker 做了 50 个任务,其中 30 个被合并进主干,并且进入了生产环境。第二个人的 Worker 生成大量代码,几乎全部在 review 里被拒绝。他们花的钱一样,但他们的贡献显然不应该一样。代码是否长期留在仓库里,只是众多弱信号之一。一段后来被删掉的原型,可能恰恰教会了团队正确的设计;一段活得很久的底层代码,有时只是因为它写得早。
因此真正需要的是 Proof of Useful Contribution。重点不是你消耗了多少算力,而是:你给项目留下了多少真正有用的东西。
烧掉的算力堆在左边;被验收的那一小块才算贡献。
这条链上每一个箭头都是硬问题,最硬的是 Accepted。谁来 accept?如果 AI 评审 AI,“制造问题再自己修复”那类作弊就没有底。如果人来评审,评审立刻成为瓶颈。生产变便宜之后,稀缺的往往不再是生产,而是判断力、品味和架构一致性。Maintainer 和 architect 不是可有可无的荣誉职位,他们的判断本身也是高价值劳动,也需要被归因。没有这个角色,几百个独立 Worker 产出的,很容易是一堆互不兼容的局部最优。
Accepted 的判定本身就需要治理:谁来审,用什么标准,如何防止刷量。这不是一个可以一笔带过的细节,而是整个模型能不能成立的前提。
Contribution 不只是代码
软件行业长期有一个偏见:只有写代码才算“建设产品”。现实当然不是这样。一个软件成功,需要供应和需求两端同时成立。有人写出了一个非常优秀的产品,但没有人知道它存在,这个产品仍然可能失败。而有人可能根本没有写过一行代码,却真正带来了第一批客户。
因此 Crowd Building 中至少存在几类不同 contribution。
Supply Contribution 让产品能够被制造出来:code、component、design、testing、compute、research、infrastructure。
Demand Contribution 帮助项目知道什么值得做:一个真实用户提出需求,domain expert 帮助定义 workflow,早期客户帮助验证价格,用户测试 prototype 并指出真正的问题。
Distribution Contribution 帮助产品到达真正的市场:介绍客户、sales、marketing、content、community、localization、onboarding、retention。
过去一个优秀 salesperson 可能对创业者说:“你把这个做出来,我能帮你卖二十套;我自己介绍来的客户,你给我一定比例佣金。” 如果真的卖出了二十套,这部分收入为什么不应该归因给他?他没有写代码,却创造了收入。未来系统应该能够识别这种价值,而不是把它视作产品开发结束以后附带的一项销售成本。
一个需求定义如果导致产品方向重大调整,一段被合并并进入生产的代码,一次可归因的成交,都应该能在系统里被捕捉。难的不是列出这些类别,而是让“被采用”和“下游价值”变成可验证的记录,而不是事后回忆。
Pre-sale 不购买 Contribution
这里需要一个重要的边界。购买产品和贡献项目应该是两件不同的事情。
Pre-sale:购买未来产品,获得产品和折扣。Contribution:创造真实价值,获得 Contribution Credit。因此:
Purchase gives access. Contribution must be earned.
Pre-sale 本身甚至可以完全不产生任何 credit。但它可以成为一种 qualification。因为已经付钱等待产品的人,和路过随口说一句“你们应该做 X”的人,并不具有同等的信息可信度。一些项目可以规定:只有 pre-sale customer 才能参加某些需求定义、prototype evaluation 或 customer-specific contribution tasks。
这并不是说钱可以买 contribution。恰恰相反。它表示:钱只证明你真的是这个问题的 stakeholder。 真正的 contribution 仍然来自之后做出的事情。这样可以避免 AI 时代一个必然的问题:idea 极度廉价,噪声极度昂贵。
从 Miner 到 AI Miner
这个模型其实和早期 blockchain 中的 miner 有一种意外的相似性。传统 miner:自己购买机器,自己支付电费,接入网络,完成网络需要的工作,获得奖励。未来的 AI Worker:自己购买 AI / compute,接入自己的 Worker Pool,选择项目,Worker 完成项目需要的工作,获得 Contribution Credit,项目产生收入后获得相应回报。
因此 AI 时代可以重新理解几种 miner。
Resource Miner。 过去是向网络提供云计算资源。这个模式的问题在于,通用云计算已经有极高效率的专业供应商,并不需要一个去中心化网络重新制造 AWS。未来的 Resource Miner 更合理的定义是:提供自己控制的 AI productive capacity。 不是卖服务器,而是把已有的 Claude、Codex、GPU 或 Agent 接入 Worker Pool,变成真正可以完成任务的 Worker。
Component Miner。 过去希望独立开发者提供高质量 reusable software components。现实证明,这件事非常困难。优秀的软件组件不仅要写出来,还必须长期维护、测试、兼容、文档完善并真正好用。过去普通开发者很难持续做到这些事情。AI 有可能第一次显著降低这个门槛。未来 Component Miner 不再只是一个 developer。它可以是 human judgment + AI Worker 组成的生产单元。
Operation Miner。 过去希望有人帮助产品做市场、销售和运营。但如果前面的 Component economy 没有真正形成,自然也没有足够多产品值得销售。AI 时代一旦产品供给成本大幅降低,瓶颈可能反过来变成:谁能够真正创造 demand 和 distribution? Operation Miner 也许会成为最重要的 contributor 之一。
Blocklet:技术组合之外,还要经济组合
贡献记录解决了“谁该拿多少”的问题,但软件本身还需要经济上的可组合性。今天的软件早已经高度 composable。一个产品可能使用 open-source library、cloud API、database、payment provider、AI model、frontend framework、authentication service。技术上,这些东西能够很好地组合。经济上,却几乎完全断裂。一个 npm library 可能被几十亿美元收入的 SaaS 使用,但 library 作者不会因此自动获得任何约定的收入。也就是说:
现代软件已经 technically composable,却还没有 economically composable。
这里有一个必须正面回答的反驳:如果 AI 让写代码接近免费,那么任何带价格的组件都会被立刻克隆成免费版本。npm 作者拿不到钱,技术上也许能补协议,市场上很难补的原因恰恰是“免费无摩擦复制”本身就是生态的价值来源。
所以 economic composability 只对不可轻易克隆的部分成立:运行中的 state、数据、网络效应、DID 身份、可追责的维护承诺与 SLA。对一份没有状态、没有身份、没有责任主体的纯代码库,它不成立。Blocklet 从一开始就试图站在这一侧。
一个 Blocklet 不只是代码包。它可以有自己的 DID、owner、state、dependencies、revenue policy、contributors 和经济关系。如果 Product A 使用 Component B,而 B 又使用 C,那么 A 收到收入以后,价值也可以沿着 composition graph 向下流动。例如:Customer pays 100 ABT,A 保留一部分,B 获得一部分,B 再向 B1、B2 分配,sales contributor 获得一部分,maintenance contributor 获得一部分。最终形成 Recursive Settlement。
收入沿着组合关系往下走,不只是代码被引用。
这背后有一个非常简单的原则:
If software can compose, ownership and value must compose too.
Ownership 不应该等于一个 User ID
传统软件通常有一个简单字段:owner_user_id = 123。但未来软件的 ownership 很可能复杂得多。一个 Blocklet 的 owner 可以是一个 DID。这个 DID 背后未必是一个人。它可能代表 organization、project、multisig、community、agent、另一个 Blocklet,或另一个由多个 DID 控制的 Realm。因此 ownership 本身可以形成 recursive graph。
更重要的是,“ownership”也不一定是一项不可拆分的权利。一个项目可能存在 control right、revenue right、governance right、upgrade right、usage right、transfer right。这些权利不一定属于同一个主体。所以更准确的方向是 Programmable Ownership:ownership 不是数据库里的一个 owner 字段,而是一组 machine-readable rights。
Contribution Rights 与 Settlement 应该分开
如果一个项目需要记录不同 contributor 的长期经济比例,它可以使用项目自己的 contribution token 或 rights mechanism。例如某种 VC token。这里 VC 表征的不是 payment currency,而是:这个 DID 对这个 Project 拥有什么 contribution / revenue / governance rights。
不同项目完全可以有不同规则。有的不可转让。有的满足一定条件以后可转让。有的只有 revenue entitlement。有的还有 governance。这些规则属于项目,而不是协议统一规定。
与此同时,整个经济体可以使用一个统一的 settlement asset,例如 ABT。这样:project rights 决定谁该拿多少。ABT 决定价值如何移动。 客户甚至可以用美元支付。系统财务可以始终以美元记账。到真正 payout 时,根据当时 ABT 的市场价格计算应该支付多少 ABT。因此:
Fiat defines price.
Project rights determine entitlement.
ABT settles value.
这避免了过去很多 token system 的问题:一个 token 同时想承担 ownership、governance、payment、incentive 和 speculation 五种职责。这些职责没有必要绑在同一个 asset 上。
这里也必须承认一个现实约束。通过劳动获得的、未来可分享收入的权利,在不少法域里会碰到监管和劳动关系的问题。公司、合同、责任主体不会因为协议写得漂亮就消失。Legal wrapper 仍然需要回答:谁签合同,谁承担责任,rights 落在哪个主体上。回避这一点,整篇文章很容易被归到“又一个 token 叙事”里。而这恰恰是我想避免的。
一个 Project Marketplace 会是什么样?
当上面的机制组合起来以后,会自然出现一个很有意思的 marketplace。但它不是 AI agent marketplace,也不是 freelancer marketplace。它真正的核心对象是 Project。
一个项目页面也许显示:148 位 committed customers,36 笔 pre-sale,prototype 完成 42%,23 个 active Worker,当前最缺 testing 和 distribution,第一笔收入 3,800 美元。参与者可以选择 Pre-order、Contribute、Deploy Workers、Help Sell。
这时候一个人拥有 20 个 AI Worker,会像今天投资者管理 portfolio 一样观察不同项目。但他分配的并不是钱。他分配的是 productive capacity。他可能判断:Project A 需求很强,我派 8 个 Worker;Project B 很有潜力,但我不懂这个领域,只派 2 个;Project C 我自己特别需要,而且我认识很多客户,我同时参与需求、build 和 distribution。
这是一种很不同的市场行为。传统 speculation 是:发现可能成功的东西,买进去,等。这里则是:发现可能成功的东西,加入生产,帮助它成功。 可以称作 Productive Speculation。不是因为投机本身值得鼓励,而是因为人类对机会的判断本来就是一种非常强的资源分配机制。如果可以把这种判断从“买入资产”转化成“投入生产能力”,它可能产生比纯金融投机更有建设性的结果。
一个更具体的画面也许是这样。有人长期抱怨某个真实的工作流没有像样的工具。12 个人预购,形成第一批 Founding Customers。三个人把自己的 Worker 派进去:一个修核心路径,一个补测试和文档,一个做销售材料。需求定义来自预购客户里的一位从业者,第一笔 3,800 美元进账以后,沿着被采用的产出和成交归因回流。数字可以变,结构不变:需求被付钱证明,生产被验收证明,收入成为最终验证。
软件也许会逐渐成为自己的经济组织
如果把这些东西推到足够远,一个 Blocklet 或 Project 会越来越不像传统意义上的“一个公司拥有的软件”。它自己可能拥有 DID、code、state、customers、Worker、contribution graph、revenue、ownership rights、settlement rules,以及 dependent components。它甚至可以拥有其他 Blocklet。其他 DID 也可以拥有它的不同 rights。
这时候一个问题会自然出现:软件和公司的边界在哪里?
过去:company owns software。未来有可能出现另一种结构:software itself becomes an economic organization.
这不意味着法律公司会消失。在税务、合同、责任、知识产权等现实世界问题上,公司仍然极其重要。但公司不一定再是数字协作唯一能够存在的容器。就像互联网让信息可以在机构之间自由流动一样,AI 和 blockchain 也许会让生产能力与经济关系更容易跨越组织边界。
这不是为了制造新的 Token Economy
这里最容易被误解的地方,就是把所有这些再次理解成:“发一个 token,然后让大家来炒。” 这不是我想讨论的问题。事实上,整个模型完全可以在没有公开可交易 token 的情况下运行。
Pre-sale 是购买产品。Worker 是生产资源。Contribution Credit 是贡献记录。Project rights 可以不可转让。ABT 只是 settlement。
如果某个成熟项目未来真的产生稳定现金流,它的某些 ownership rights 当然可能被市场定价,甚至被金融化。这是一个几乎无法避免的经济现象。任何持续产生现金流的权利最终都具有价值。但那应该是价值创造之后可能发生的事情,而不是项目存在的理由。
过去很多 crypto 项目走的是:token → speculation → funding → hope that product appears。我更感兴趣的是反过来的路径:
Demand → Contribution → Product → Revenue → Rights → perhaps, eventually, a market.
先有生产。先有客户。先有收入。市场如果后来出现,让市场自己出现。
为什么今天可能和十年前不同
很多这样的想法在十年前听起来会非常理想主义。原因并不是 blockchain 做不到。真正缺失的是生产层。让几百个互不认识的人一起写出一个高质量的软件,协调成本太高。于是最有效率的办法仍然是:成立公司,雇人,设 manager,统一管理。
类似的实验也失败过,而且失败得很具体。Gitcoin 撞上过 sybil。SourceCred、Coordinape 容易退化成人气投票。各类 DAO 反复遇到治理俘获。Kickstarter 证明了预购可以存在,也证明了交付率是另一回事。开源本身更有意思:Linux 用相当松散的协作做出了极高质量的软件,并不需要 contribution token。为什么?因为大量贡献者由公司发薪,价值捕获发生在别处。这一点其实支持、而不是削弱前面的论点。我们要面对的,正是“价值捕获与贡献发生在不同地方”这个历史遗留问题。
AI 正在降低协调成本。一个人已经开始可以拥有相当于过去一个小团队的生产能力。如果这种能力可以通过标准 Worker Pool 接到 ARC 上,如果 Darc Factory 能够可靠地拆解、协调和验证工作,那么 loosely coordinated production 第一次可能不再只是理论。
Blockchain 在这里也终于不需要被解释成“为什么软件一定要上链”。它承担的是一个更具体的问题:当生产者彼此独立、不属于同一个公司时,大家怎样拥有一个共同可信的 identity、provenance、ownership、payment 和 settlement layer?
AI 让 loose production 成为可能。Blockchain 可以让 loose economic coordination 更可信。
最终可能出现的,是一种新的软件生产方式
我们今天熟悉的软件生产方式是:创始人 → 公司 → 融资 → 员工 → 软件 → 用户。未来也许会出现另外一种路径:
有人真正需要某个东西,一群人用购买承诺证明这个需求,懂这个问题的人帮助定义它,独立的 AI Worker 开始参与生产,Components 被组合起来,更多用户参与测试和销售,产品开始产生真实收入,价值沿 contribution 和 composition graph 回到创造它的人。
这里面仍然会有失败。绝大多数 idea 仍然可能不值得做。很多 AI 产生的工作仍然可能毫无价值。贡献的公平归因会非常困难。外部 Worker 的安全、权限、作弊和质量控制也都会是巨大挑战。这些问题不会因为使用了 AI、DID 或 blockchain 就自动消失。相反,它们才是真正需要解决的问题。
但如果这些问题能够逐渐解决,我们也许第一次有机会让软件产业出现一种新的组织形式:不是所有人先加入同一家公司,才能共同创造一个产品;而是一个值得存在的产品,吸引不同的人、AI、组件、资源和市场能力临时聚集起来。
产品成为协作的中心。贡献形成经济关系。收入成为最终的验证。而组织,可以随着产品生长,而不一定必须先于产品存在。
这也许是 AI 时代最值得探索的软件未来之一。
Find something you want to exist.
Help make it real.
Share in the value you create.
找一件你希望它存在的东西。动手让它成为真的。然后分享你参与创造的那部分价值。