你的 AI 花在哪了:Agent Observability 入门
你让一个 agent 去干活:整理待办、写一段摘要、扫一遍好友的星盘。它跑完了,回了一句话。
然后是一串你答不上来的问题。这次花了多少 token?为什么这次比上次贵十倍?昨天那次为什么什么都没做完?这个月我一共花掉了多少,都花在哪个应用上?
在有 Agent Observability 之前,回答这些问题的方式是翻日志,或者猜。
Agent Observability 是 ARC 上的一个 blocklet,它把这些问题变成三个可以直接看的页面。 它不是给管理员的运维工具——你自己的调用、你自己的 run,你自己就能看到,不需要谁给你开权限。
三个页面,三个问题
| 页面 | 它回答 | 它读的数据 |
|---|---|---|
| usage | 消耗了多少 AI 容量 | 用量账本 |
| traces | 某一次 run 内部到底发生了什么 | 运行轨迹 |
| dashboard | 最近跑了什么、哪几条值得点进去 | 运行轨迹 |
三个页面共用一个名字,但读的是两份不同的数据:usage 读账本,另外两个读轨迹。这一点后面还会再提一次,因为它是这里最容易读错的地方。
「花了多少」:usage
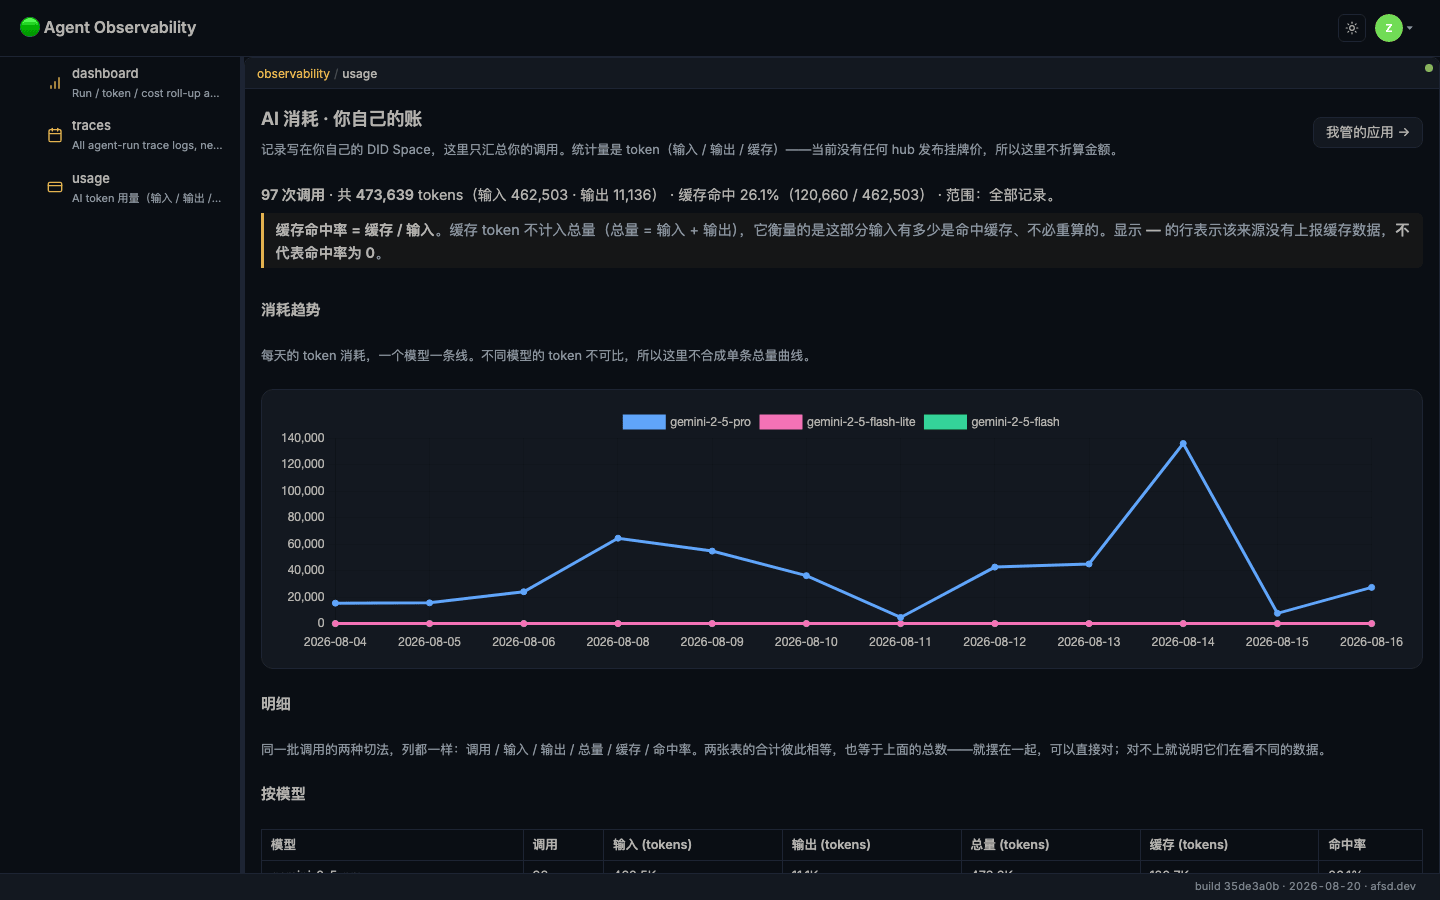
打开 /usage,第一行就是答案:97 次调用 · 共 473,639 tokens(输入 462,503 · 输出 11,136)· 缓存命中 26.1%。它按你的身份限定,不需要你自己设过滤条件——记录写在你自己的 DID Space 里。
往下是一张趋势图和两张明细表:按模型和按应用。同一批调用的两种切法,列完全一样。
有三个设计决定值得知道,因为它们决定了你该怎么读这些数字:
图表从不把不同模型的 token 加在一起。 一百万 token,跑在便宜模型和贵模型上代价差一个数量级;合成一根柱子,你得到的是一个自信的错误排名——比没有图更糟,因为错误的排名读起来像知识。所以只要横轴不是模型,图就一个模型一条线。
两张表的合计彼此相等,也等于第一行。 这是页面当着你的面自检:两张表对不上,就说明它们在看不同的数据,你不用离开页面就能发现。
表格里的数字是量级,第一行是全精度。 表格写 462.5K,总览行写 462,503——但次数永远是精确的,因为把 5,000 次和 5,400 次都写成 5K,省下三个字符却丢掉了你要用的信息。
「按应用」表里每个应用名都是链接,点进去就是「我在这个应用里花了多少」的独立页面,可以收藏、可以发给别人。
如果你管着应用,右上角还有一个「我管的应用」——那是另一个人群:一个应用在所有用户身上的消耗。它按应用逐个鉴权,你管哪个才看得到哪个。
「它当时干了什么」:traces
usage 告诉你贵,traces 告诉你为什么贵。
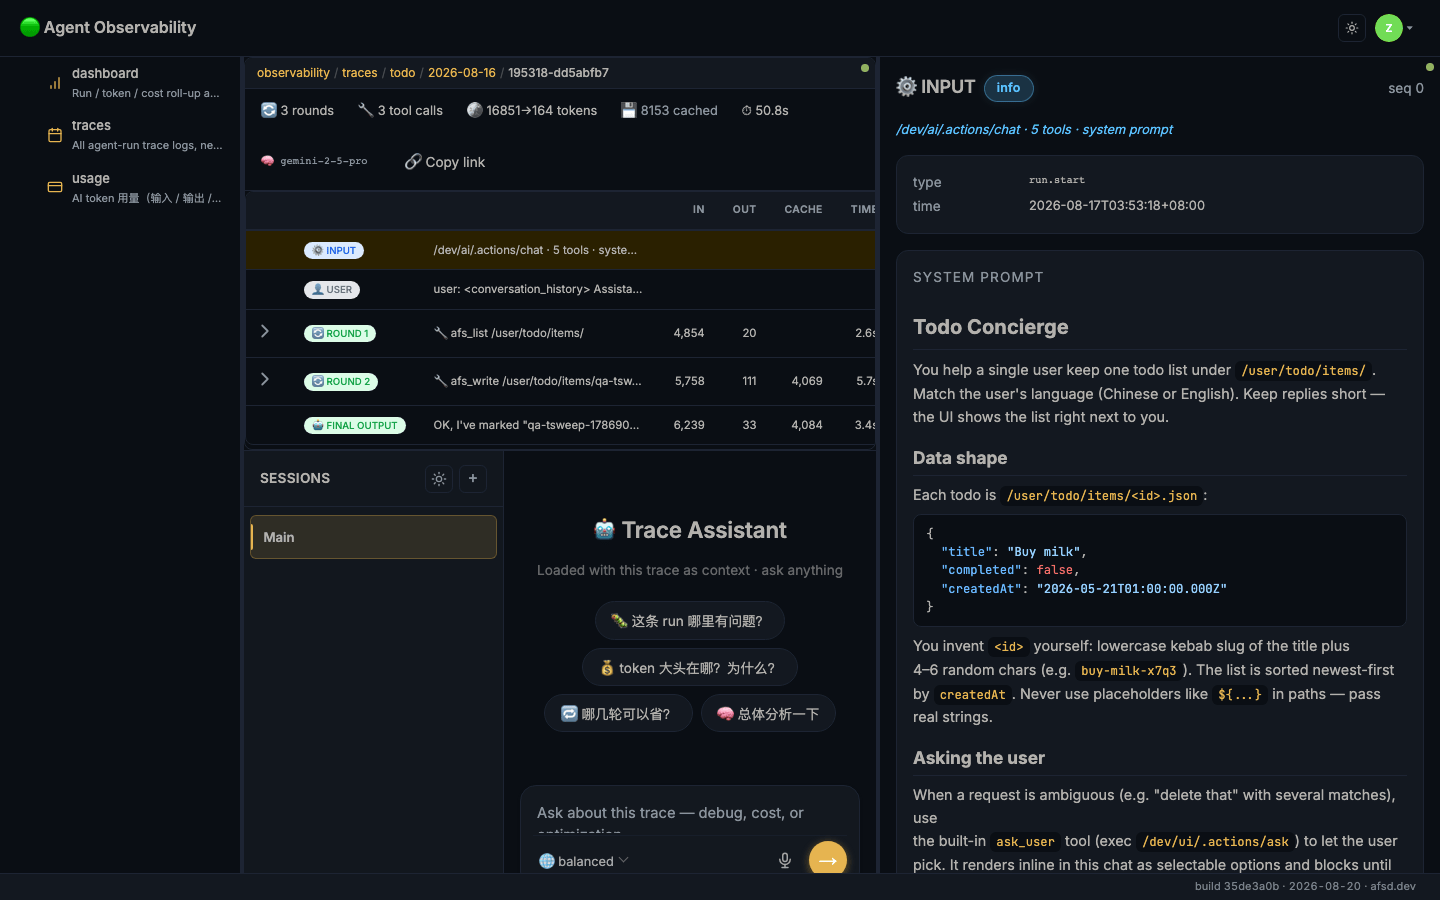
点开任意一次 run,你会看到它的完整时间线:发起这次调用的输入(带了哪些工具、有没有 system prompt)、用户说的那句话、模型跑的每一轮、以及最终回答。每一行都带自己的 token 数和耗时,所以「钱花在第几轮」是直接看出来的,不用推算。
一轮可以展开,露出它内部的每一次工具调用和结果——afs_write … ok。「agent 做错了事」是在这一层才看得见的:它读了不该读的路径、把结果写错了地方、或者在同一件事上来回试了三次。
没走到模型的 run 长得不一样:0 轮、0 token、没有时长,时间线上只剩输入和用户那两行。它通常意味着配置错了,或者根本没连上模型。
时间线下面还挂着一个 assistant,它已经加载了这条 trace 作为上下文,可以直接问「token 大头在哪」「哪几轮可以省」。它的回答自带成本 footer,比如 7877 tokens | 7393 in | 484 out——因为问它本身就是一次 AI 调用,事后会出现在你的 usage 页上,记在 observability-explorer 名下。这不是 bug,是同一套账在自洽。
「最近整体如何」:dashboard
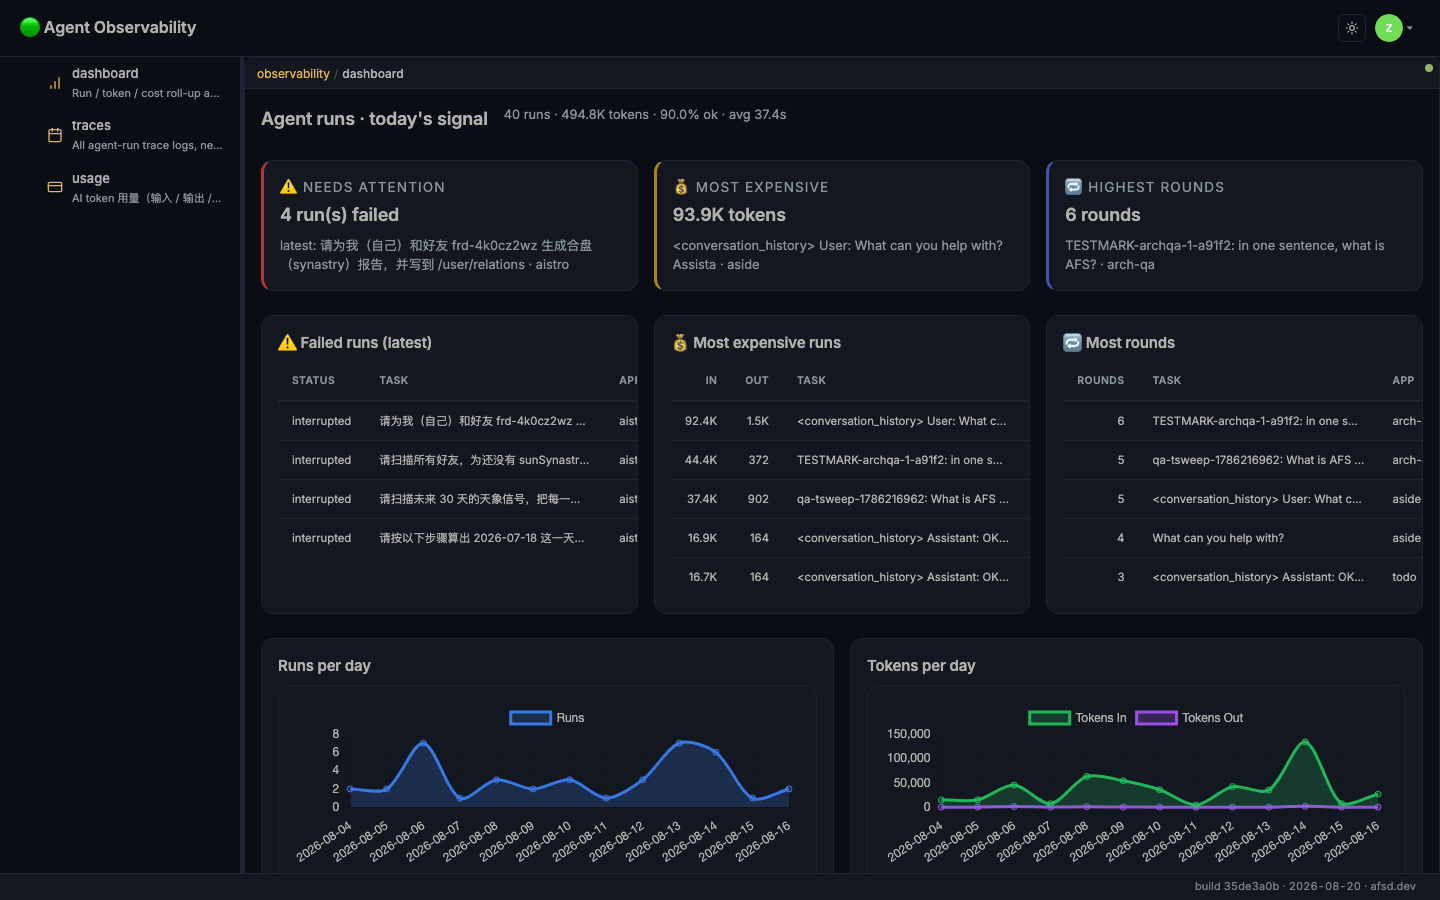
落地页回答「哪几条值得点进去」:最近失败的、最贵的、轮次最多的各一张卡加一张表,下面是每日运行数、每日 token,以及一张按应用汇总——那是唯一一处把每个应用的运行数、token、平均时长、成功率、最近运行放在同一行的地方。
一条读法提醒:总览行标着 today's signal,但它下面的图跨了十三天。把它读成「你可见范围内的当前状态」,不是「今天」。
你能看到谁的数据
未登录时三个页面都不渲染——它们会明说「请先登录」,而不是给你一张空图。
登录之后,有两条轴决定你看得到什么:
- 你自己的数据恒可见。 那一段就是你自己 DID Space 里的东西,隔离是物理的,不是一个可以被绕过的过滤条件。
- 一个应用的全部数据,需要你在那个应用上有管理身份。 逐个应用判定:你是 A 的 owner,在 B 上什么也不给。
第二条从 2026 年 8 月 18 日起才是这样。在那之前,trace 面把任意一个应用的 owner 当成了整个部署的管理员——拥有一个应用,就能读到所有应用的运行记录,包括别人任务的原文。这是一次安全走查发现并修掉的,现在两个面用的是同一个判定。
两条不先说清就会读错的边界
一、trace 和 usage 不对账。 它们由两条独立的写入路径产生:一次 run 可以烧掉 token 却不留轨迹,反过来也成立。别拿 dashboard 的运行数去除 usage 的 token 数。
二、「我的消费」和「我管的应用」对同一个人可能给出不同数字。 前者读你 DID Space 里的记录,后者读应用实例自己的账本。同一天实测:todo 在个人面是 53 次调用,在管理面(同一个用户、且只有这一个用户)是 46 次。这是一个已知的、正在追的问题;在它收敛之前,把每个面当作它自己那个问题的权威,不要拿一个减另一个。
顺带一条:管理面里的 (unknown) 不是某个用户,而是「没有可归因的人」——记录写入时没带用户 ID。所以一个应用可以同时显示 56 次调用和 0 位活跃用户。
接到你自己的界面上
每一块面板背后都是一条可读的 AFS 路径,页面自己不留任何汇总副本。所以页面能显示的东西,你自己的界面也能读——read /dev/ai/usage/summary 拿到总览,read /dev/ai/usage/daily 拿到可以直接绑图表的 JSON。固定投影回答不了的问题,走 /dev/ai/usage/.actions/query,按天、按模型、按应用、按用户分组。
从哪开始
- 在 Agent Observability 里读你的 AI 消耗 —— usage 页逐块走查,含集成用的路径清单与查询参数表
- 读 agent 运行看板 —— dashboard 逐块走查,含可见范围的完整规则
- 在 Traces 里读一次 agent 运行 —— 一条 run 从列表到时间线到 inspector
三篇文档里的每一条断言都在活环境上核验过,并钉着核验时的版本与日期。