这一页讲怎么读 Agent Observability blocklet(ARC 仓库里的 blocklets/observability-explorer)的 AI 用量面:发生了多少次 AI 调用、走的哪个模型、来自哪个应用;如果你管着应用,还包括来自哪个用户。
下面每一条都在活环境 https://observability-explorer.afsd.dev 上核验过:build 35de3a0b,以已注册测试用户的登录态,重走时间 2026-08-20。你看到的数字、应用和模型会不一样;可复用的是形状、路径和边界。
这是第二轮走查。第一轮在 build
400ce96(2026-08-15)上做,之后五天里用量面落了三处会改变读法的改动——明细表与合计行改用量级缩写、查询 action 拒绝写错的顶层参数、应用一览补上 DID Space 发布的 blocklet——所以全部截图与数字按新 build 重拍重写,而不是打补丁。
「observability」这个名字下面是两个东西
这个 blocklet 侧栏有三个区,回答的问题和读的数据都不同:
| 区 | 路由 | 回答什么 | 数据来源 |
|---|---|---|---|
| dashboard | /dashboard | 发生过哪些 agent run | trace 记录 |
| traces | /traces | 某一次 agent run 内部发生了什么 | trace 记录 |
| usage | /usage | 消耗了多少 AI 容量 | 审计账本(/dev/ai/usage) |
本页只讲 usage。 trace 与 usage 之间不对账,也不互相派生——一次 run 可以只烧 token 不留 trace,反过来也成立。想知道「这个 agent 当时为什么那么干」,去看 traces,不是这一页。
打开它
用量面是两条路由,各对应一个人群:
https://<你的 observability 域名>/usage          ← 你自己的调用,跨所有应用
https://<你的 observability 域名>/usage/admin    ← 所有用户的调用,限于你管理的应用
未登录时两个面都不渲染。它写明原因,而不是给一张空图:
登录之后,/usage 按身份限定到你,不需要自己设过滤条件。记录写在你自己的 DID Space 里,这一页只汇总归属到你的调用。
个人面:/usage
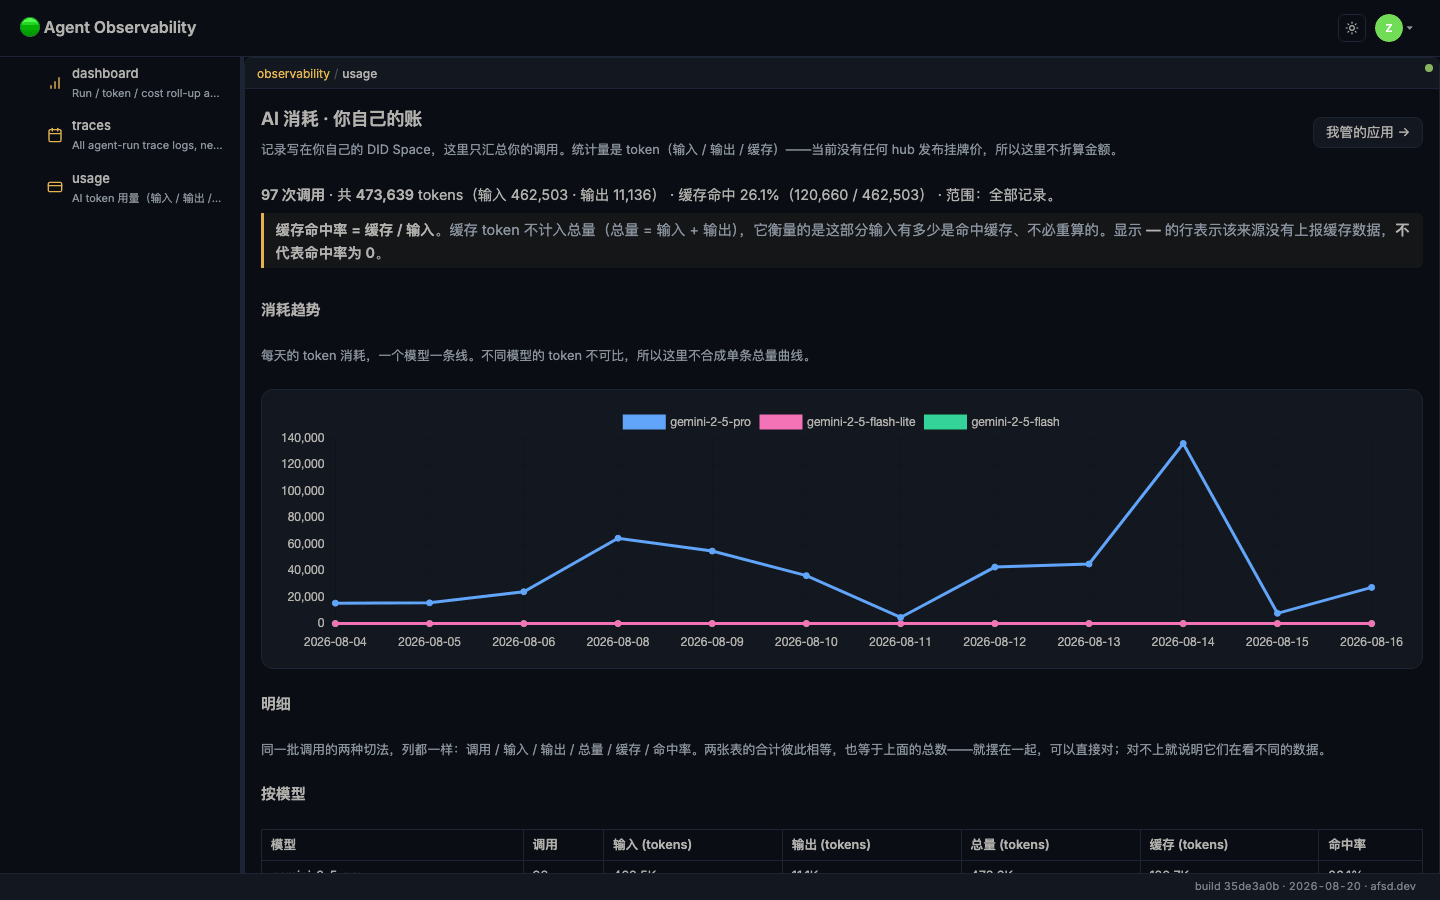
从上往下读——每一块都在限定它上面那一块。每一块都绑定在 /dev/ai/usage/ 下的一条路径上:
| 区块 | 陈述什么 | 绑定到 |
|---|---|---|
| 总览行 | 调用数 · 总 token(输入 + 输出) · 缓存命中率及其分母 · 时间范围 | summary |
| 缓存说明块 | 缓存 token 不计入总量;— 表示「没上报」,不是「0」 | 同上 |
| 消耗趋势 | 每天的 token 消耗,一个模型一条线 | daily |
| 按模型 | 每个模型的 调用 / 输入 / 输出 / 总量 / 缓存 / 命中率 | table-by-model |
| 按应用 | 同样的列,按调用方应用切分,另加一列 模型构成 | table-by-caller |
有三条是刻意设计的,读数字之前先知道。
任何图表都不跨模型加总 token。 一百万 Haiku token 和一百万 Opus token 的代价差一个数量级以上,把它们并成一根柱子或一条线就是一个「自信的错误排名」。所以只要标签轴不是模型,图就按模型拆成多条 series。表格会给跨模型合计——那正是你来看的数字——它换一种方式化解风险:每一行都带模型构成。
表格里的 token 数是量级缩写,全精度在总览行。 明细表的单元格和 合计 行都写成 462.5K / 473.6K 这样的量级(ARC #3948 起,合计 行在 #4164 收口时跟上),而计数——调用次数、活跃用户数——永远是精确值:一个缩写过的头数(5,000 还是 5,400 次调用)省下三个字符,却丢掉读者要用的信息。要全精度的 token 数,读总览行:它同样由格式化函数打印,仍然是 473,639。
两张表的合计彼此相等,也等于总览行。 这是这一页的自检:如果「按模型」和「按应用」对不上,说明它们在看不同的数据。缩写不破坏这条不变式——它保持成一条精确的等式:合计 = compact(总览行的同一个数)。
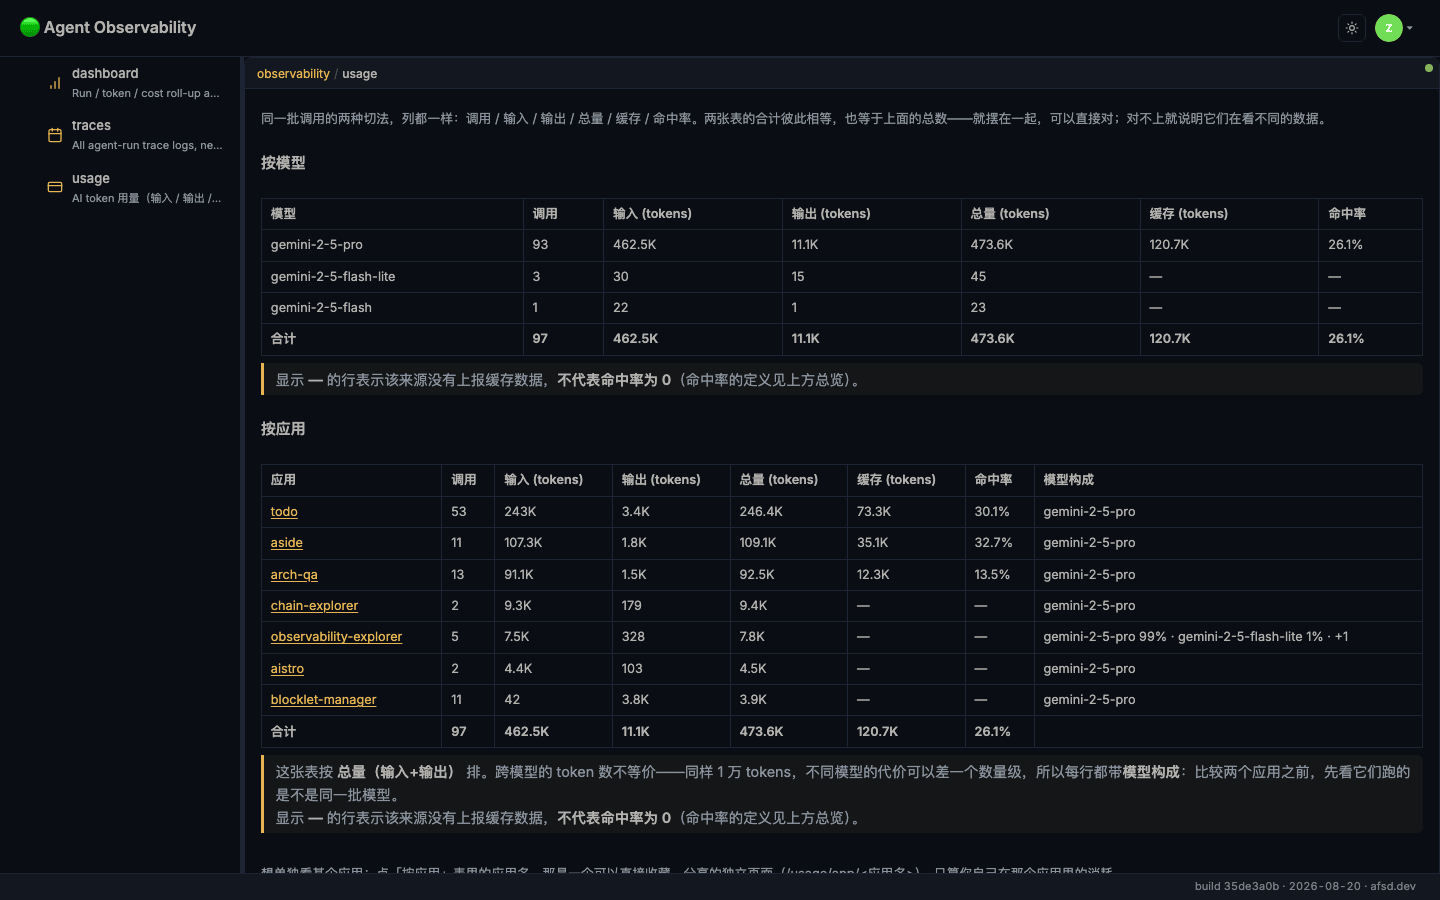
没有调用的日期是被略过的,不是填 0。 截图里趋势轴从 08-06 直接跳到 08-08,因为 08-07 没有调用。缺口读作「没有」,不是「零」。
单个应用,自己一页
「按应用」表里的每个应用名都是链接,指向只讲那个应用的可分享页面:
/usage/app/<caller> 例如 /usage/app/todo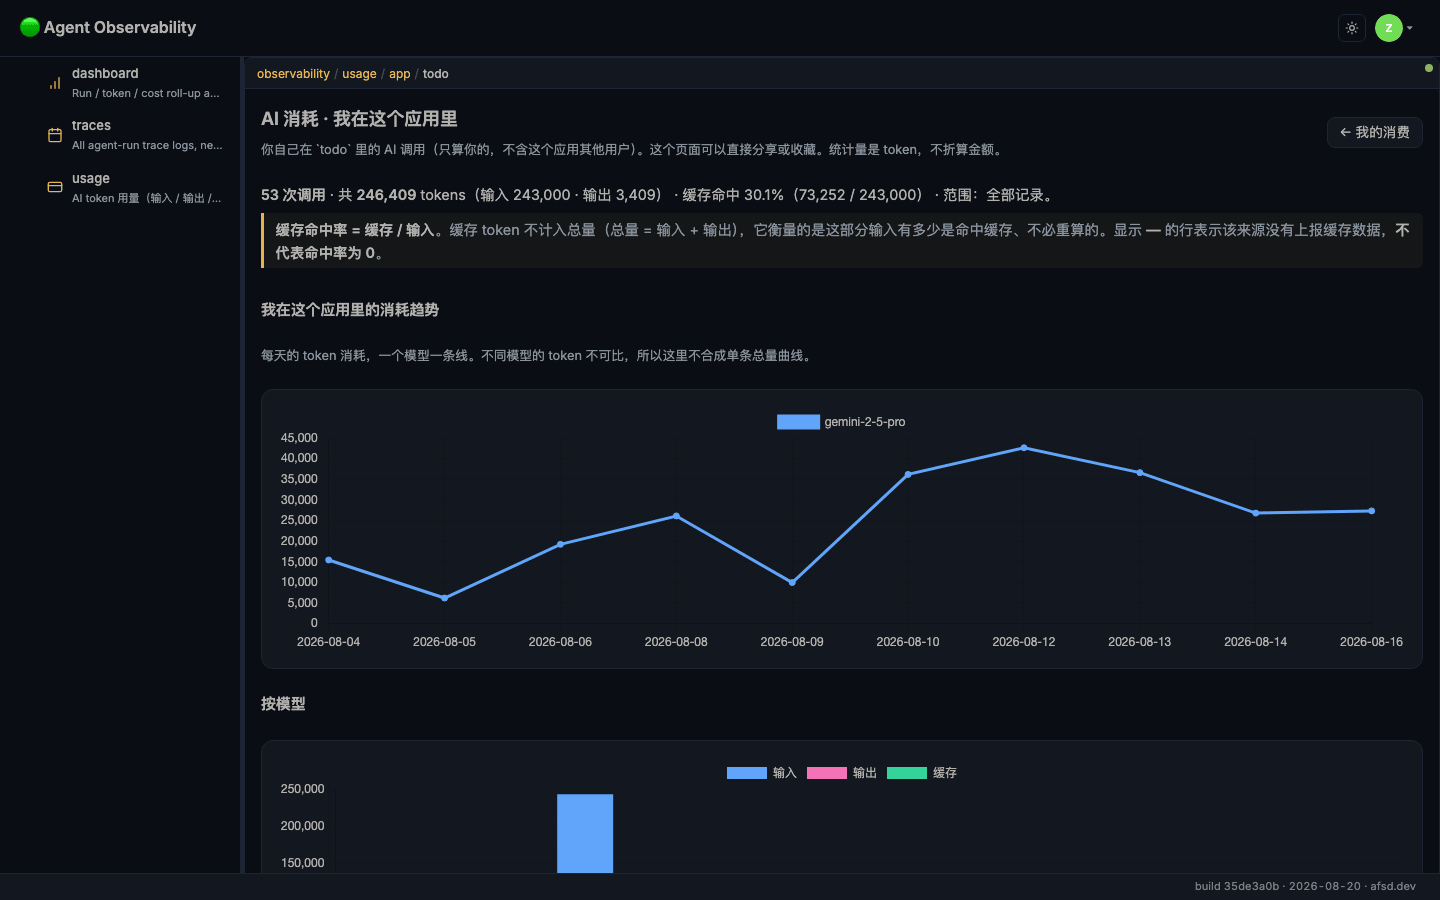
这是你在那个应用里的消耗,不是那个应用的总量。它的总览行与 /usage 上该应用那一行严格对得上:本次走查里 todo 两处都是 53 次调用 / 246,409 tokens。页面带「← 我的消费」回到完整汇总。
它的面板只有 daily、by-model 和 table-by-model。by-caller / by-instance 是刻意不放的:人群已经收窄到一个应用,这两个图只会画出一根柱子。
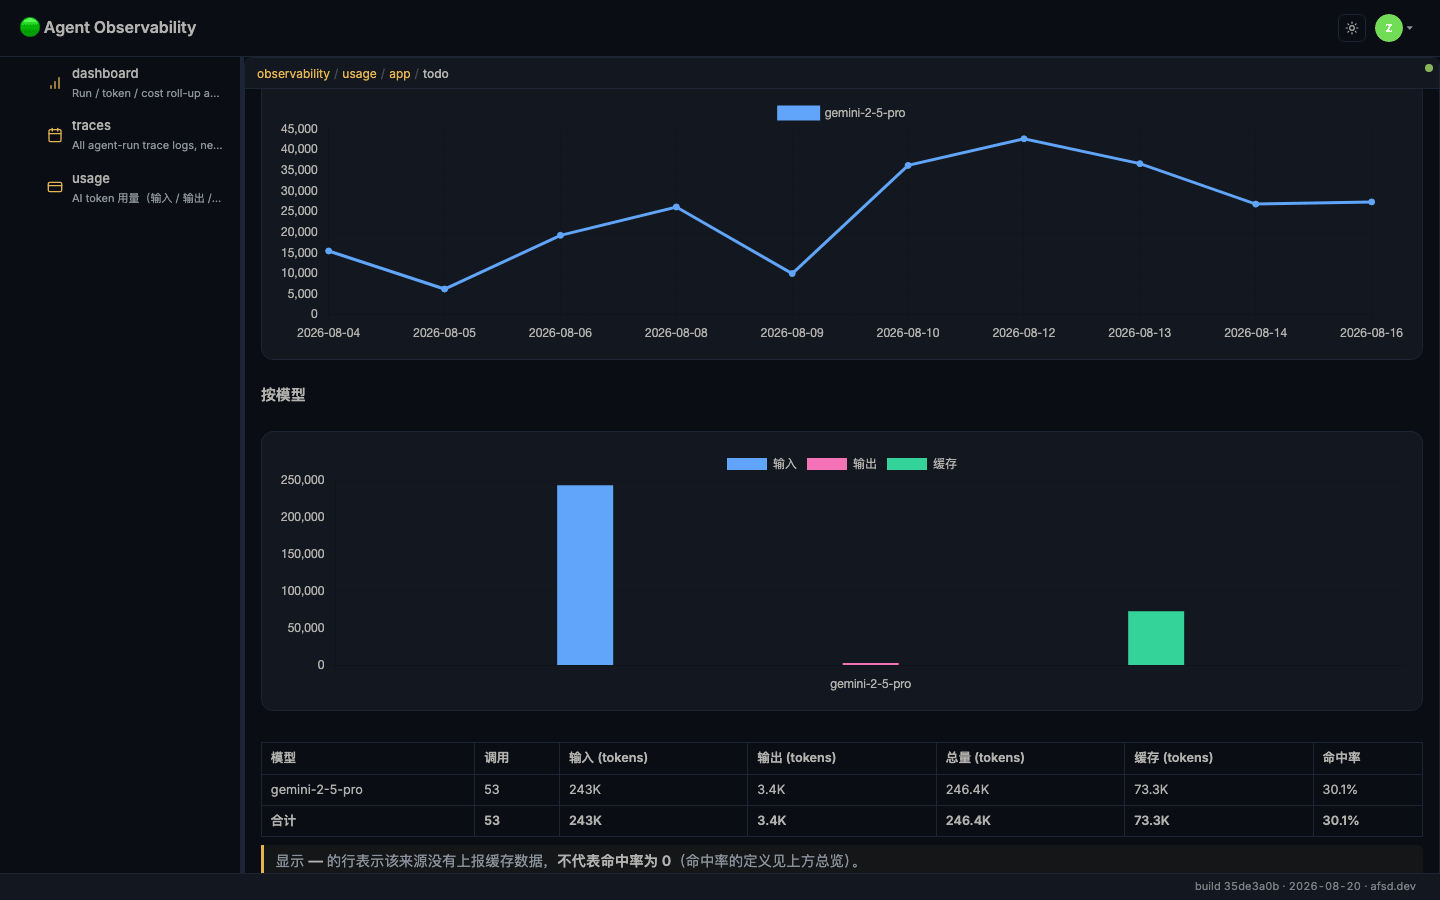
一条渲染上的注意,上图里能直接看到:当输入与输出相差两个数量级时——这一页是 243,000 对 3,409——纵轴按输入缩放,输出那根柱子细成一条线。这时以表格里的数字为准。
管理面:/usage/admin
只有 admin / owner 身份的调用者能看见。/usage 读的是你在所有应用里的账,这里读的是一个应用在所有用户身上的账——不同人群。这也是它们被拆成两页而不是两个 tab 的原因:两边的总量本来就不该互相比较。
| 区块 | 陈述什么 | 绑定到(/dev/ai/usage/admin/ 下) |
|---|---|---|
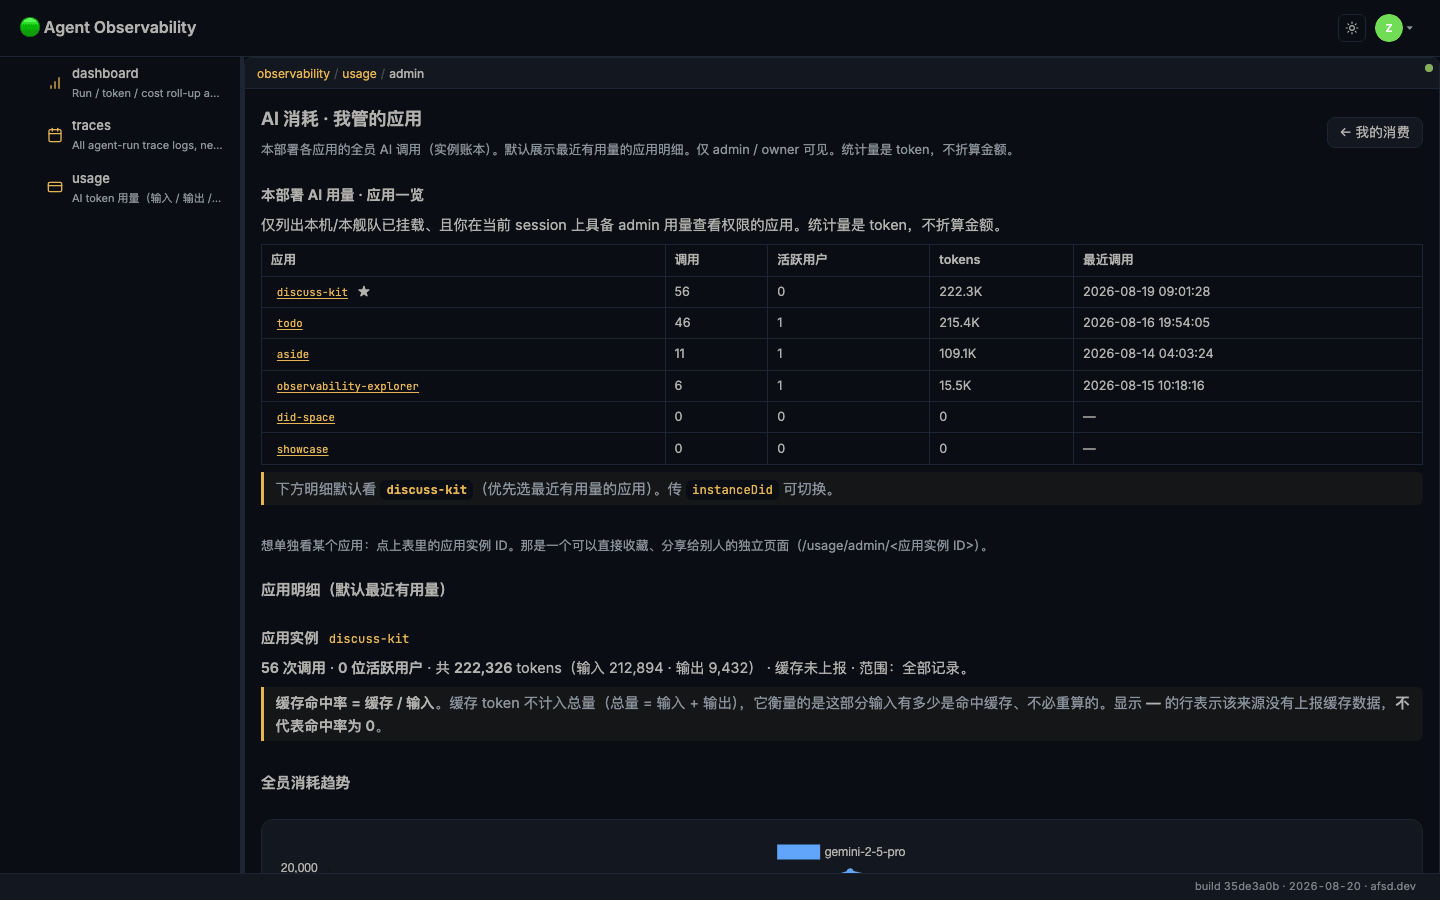
| 应用一览 | 你可以查看的每个应用一行:调用、活跃用户、tokens、最近调用 | apps |
| 下方明细 | 单个应用的完整拆解——总览、趋势、按用户表、按模型表 | <projection> |
下方明细看的是哪个应用会变。 它取「你有权限、且最近有用量的那个」,表里用 ★ 标出当前选中的那个,所以把 /usage/admin 这个链接发给别人,对方看到的是当时最活跃的那个。要稳定地指向一个应用,用它自己的路由。
一览里会有 0 调用的行,那是对的。 它列的是「你有 admin 用量查看权限的应用」,不是「有用量的应用」——上图里 did-space 和 showcase 两行全 0。反过来,DID Space 发布的 blocklet 一度整批漏在这张表外(只枚举了静态 registry 那条腿),修在 ARC #3950;如果你对接的是 08-16 之前的 build,这张表会少一截。
往下翻过应用一览,明细块的读法和个人面一样,只是个人面的「按应用」换成了「按用户」:
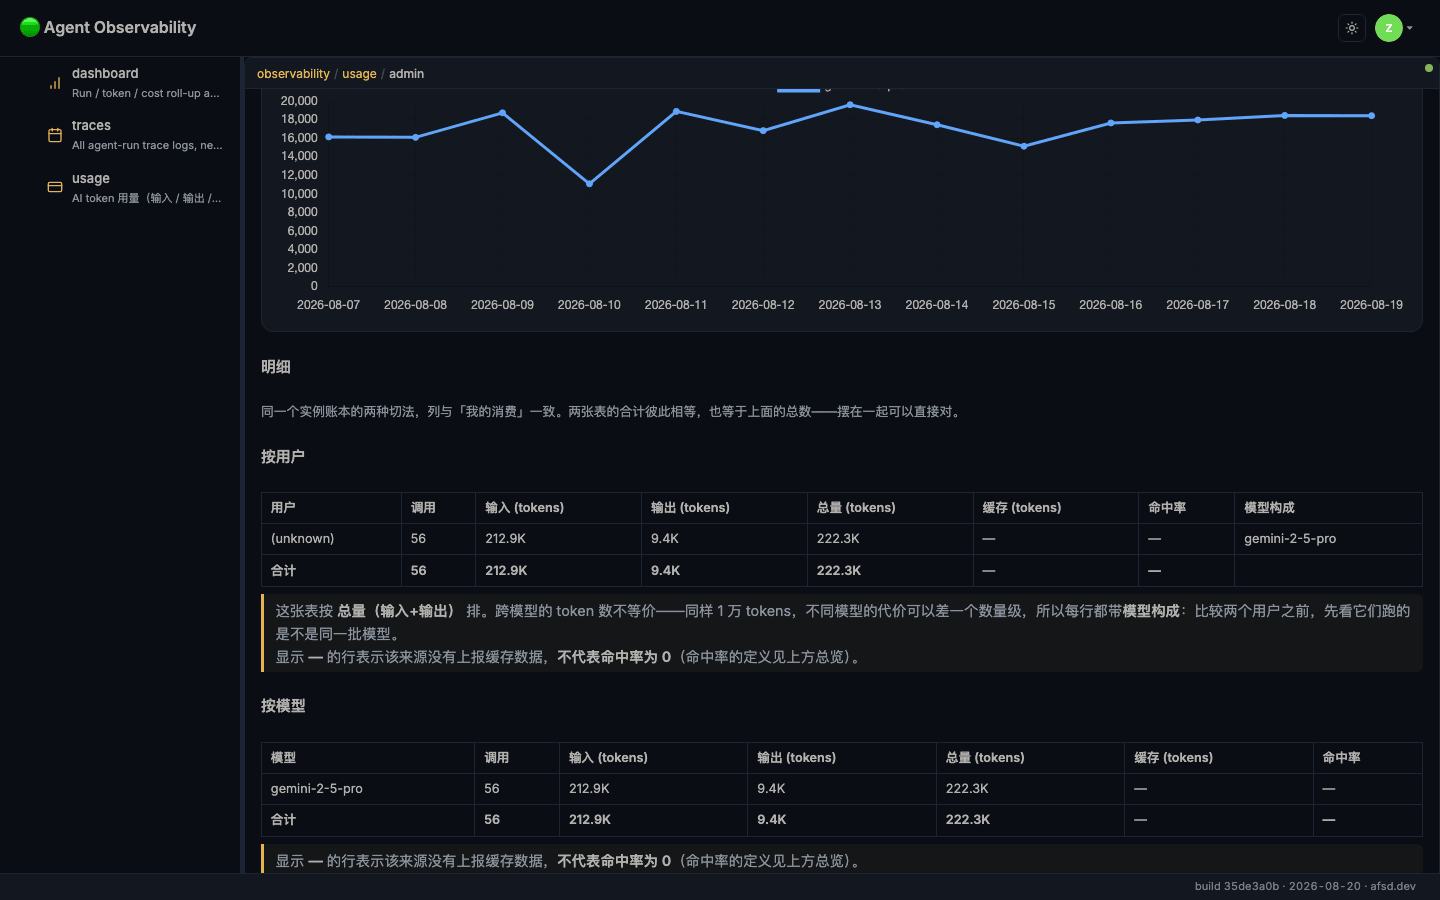
上图里 (unknown) 那一行是 56 次没带用户 ID 的调用——正是这批记录让应用一览里 discuss-kit 显示「0 位活跃用户」。
单个应用,以及应用里的单个用户
/usage/admin/<instanceDid>                 例如 /usage/admin/discuss-kit
/usage/admin/<instanceDid>/u/<userDid>     单个用户在这个应用里的消耗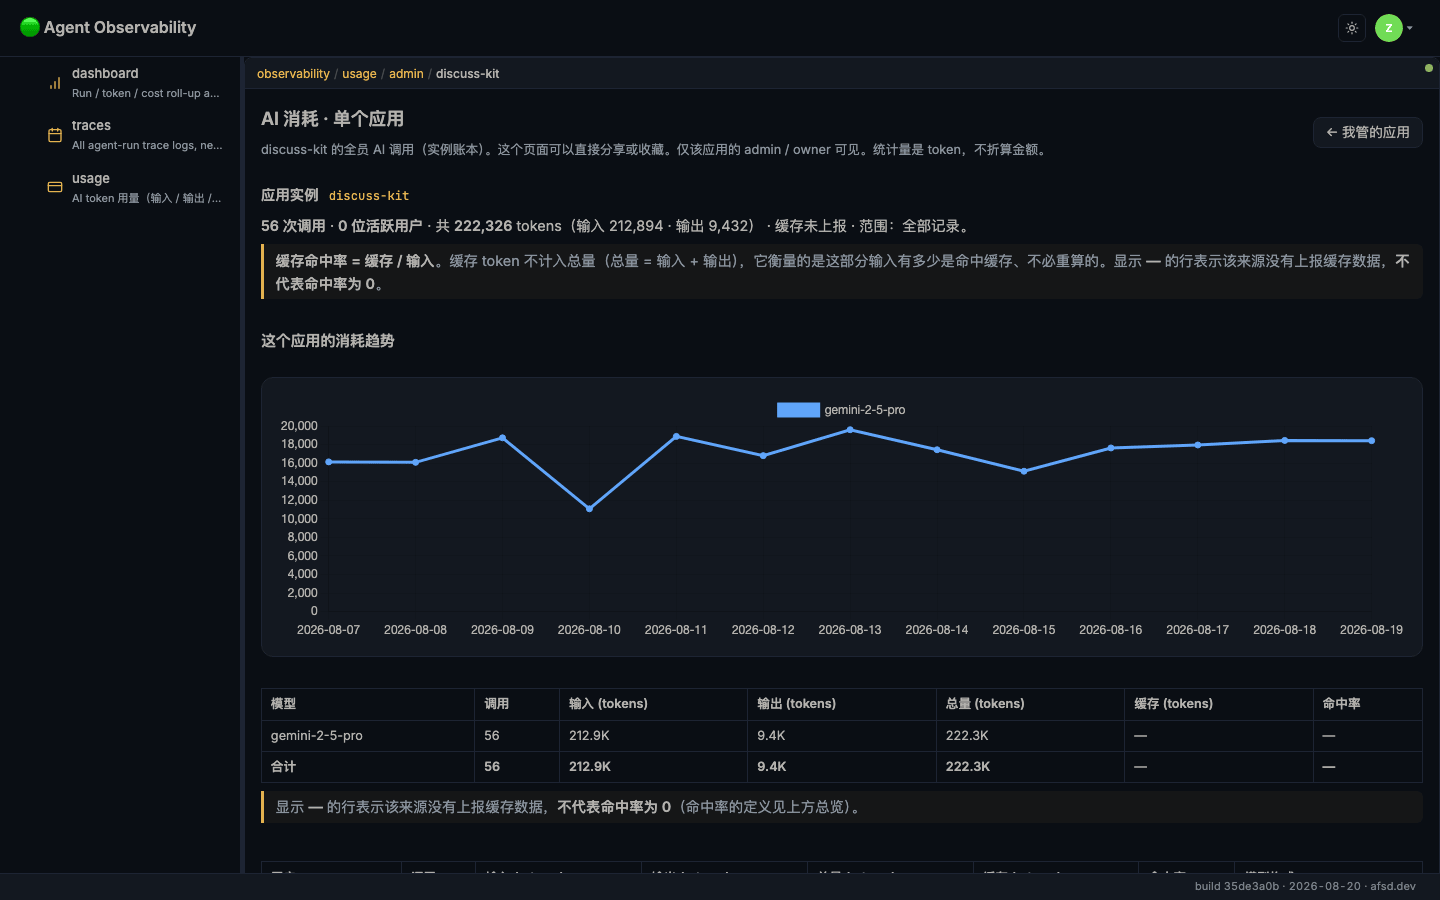
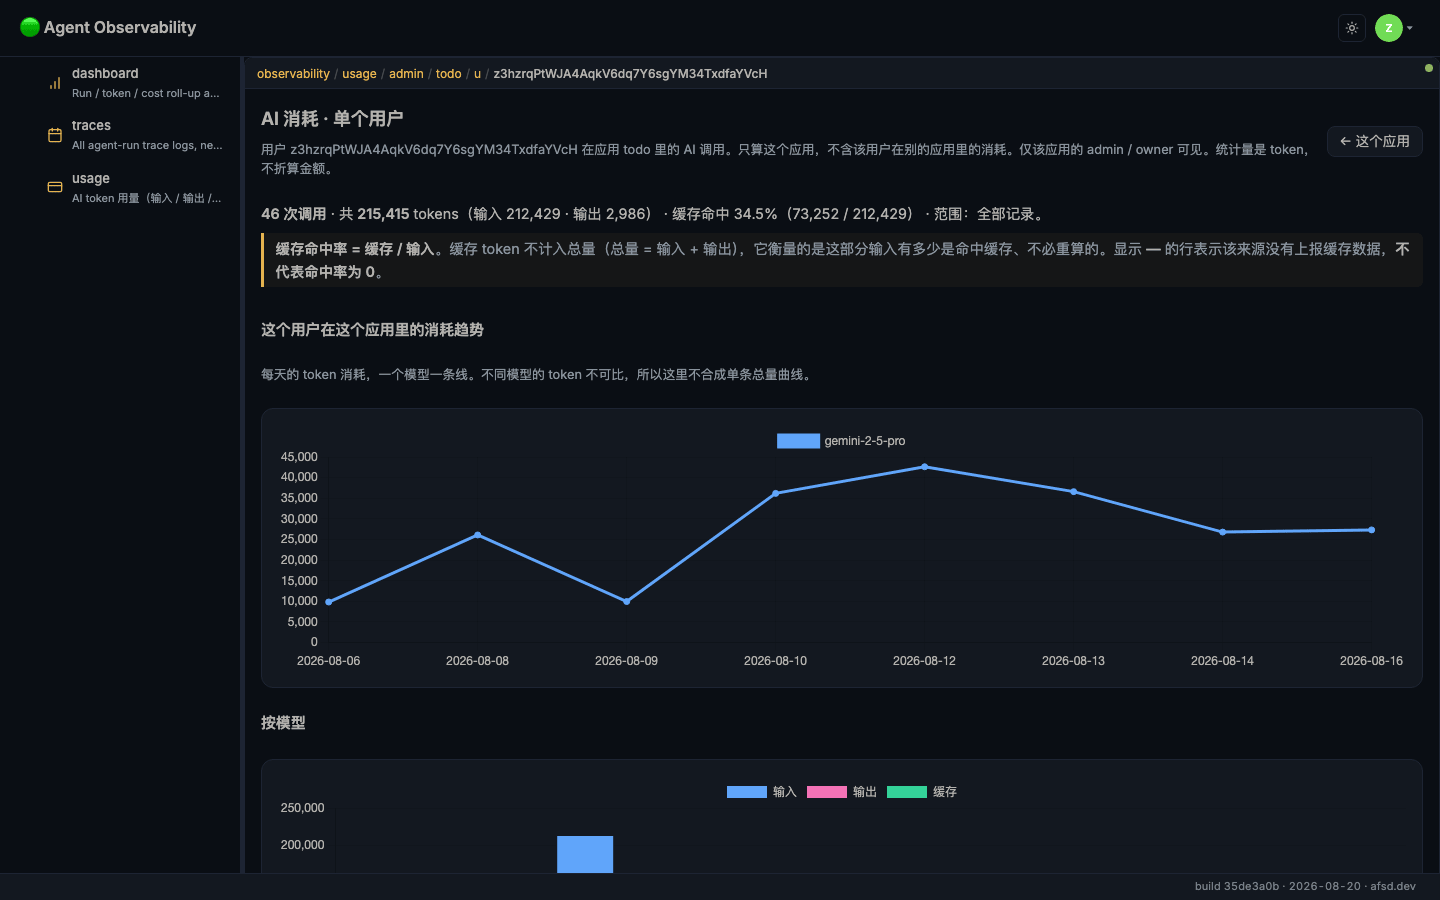
两条路由都能硬加载、可分享;应用一览里的应用 ID 和按用户表里的 DID 就是通向它们的链接。归到 (unknown) 的行不是链接——那一行是什么意思见下面。(截图里的 DID 是测试部署上一个已注册的测试 fixture 账号。)
不存在的应用 ID——或者你无权查看的那个——落到的是同一个页面骨架,但给的是诚实的空态,不是报错,也不是一排 0:
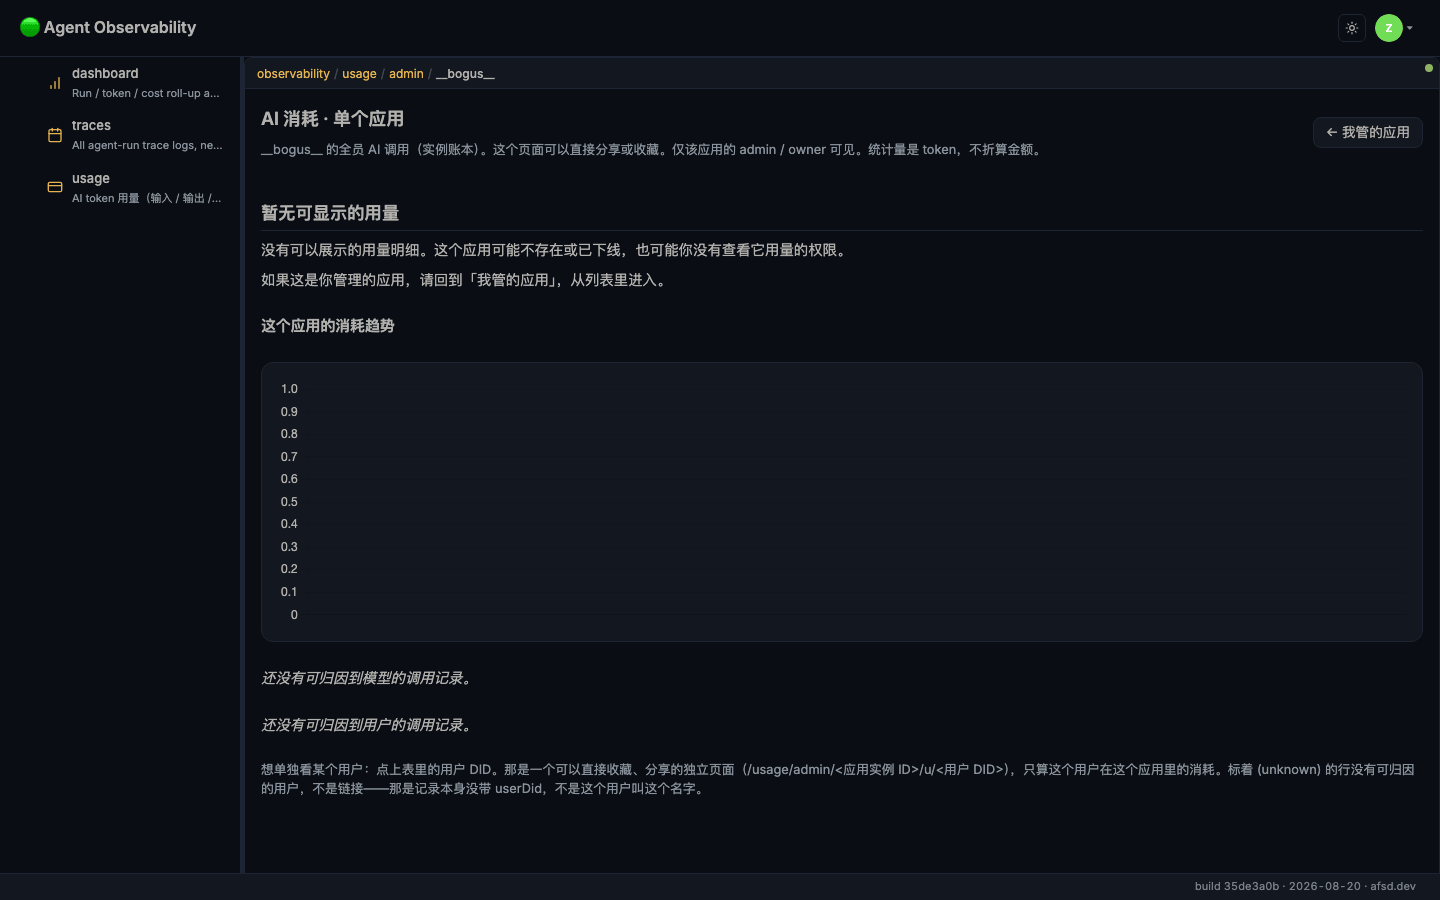
在别处集成同一份数据
上面每一个面板都绑定在一条可读的 AFS 路径上。页面自己不留任何汇总副本,所以页面能显示的东西,你自己的界面也能读。
可读投影
read /dev/ai/usage/<projection>| 投影 | 类型 | 内容 |
|---|---|---|
summary | markdown | 总览句 + 缓存定义 + 完整性告警 |
table-by-model table-by-caller table-by-instance | markdown | 明细表(每个维度的列完全一样) |
daily by-model by-caller by-instance | JSON | {labels, datasets} —— Chart.js 形状,可直接绑定 |
单应用:/dev/ai/usage/app/<caller>/{table-by-model,daily,by-model}。
管理面:/dev/ai/usage/admin/{summary,apps,table-by-model,table-by-user,daily,by-model,by-user},以及 /admin/<instanceDid>/<projection> 和 /admin/<instanceDid>/u/<userDid>/<projection>。
投影名写错是报错,不是返回空:
read /dev/ai/usage/table-by-user
→ unknown usage projection "table-by-user" — expected one of
  summary | table-by-model | table-by-caller | table-by-instance |
  daily | by-model | by-caller | by-instance
admin/ 这一段不是这个行为。 /dev/ai/usage/admin/<x> 会把认不出来的 <x> 当作应用 ID,所以在 admin/ 下写错投影名不会报错,只会拿到「暂无可显示的用量」空态。在 admin/ 下面,拼写要自己检查。
为什么会有「投影」这层
AUP 的 chart 节点通过 node.src 绑定实时数据,而 node.src 必须是一条可读的 AFS 路径——exec action 绑不上(providers/runtime/ui/src/aup-registry.ts)。没有可读投影,页面就只能自己调 window.afs.exec() 再把结果注进去,而那正是 ARC 明令禁止的 renderer 纯度违规。这就是为什么每多一层下钻,就要多一组可读路由,而不是写一条更聪明的查询。
自己动手接的时候,这条会立刻碰到:每一个想绑的面板,都要先规划一条可读路径。 数据只活在 action 后面,图表就看不见它。
查询 action
固定投影回答不了的问题走这里:
exec /dev/ai/usage/.actions/query { groupBy, where, from, to, limit, includeCost }
exec /dev/ai/usage/admin/.actions/query { instanceDid, ...同上 }| 参数 | 接受什么 |
|---|---|
groupBy | type model hub caller instanceDid userDid day —— 字符串或数组,自动去重 |
where | 同样的键(除 day),每个值是字符串或字符串数组 |
from / to | ISO 日期;下界闭、上界开 |
limit | 正数(默认 100) |
includeCost | true 时在 hub 有挂牌价的地方附上成本估算 |
一次真实调用与它真实的返回,取自运行中应用的浏览器控制台:
await window.afs.exec('/dev/ai/usage/.actions/query',
                      { groupBy: ['day'], where: { caller: ['todo'] } })
// → { groups: [...], totals: { calls: 53, totalTokens: 246409, ... },
// groupCount: 10, scanned: 53, skipped: 0, groupBy: ['day'], range: {} }这个查询是刻意严格的:未知维度、where 里的未知键、无法解析的日期、颠倒的时间范围,都会抛错而不是降级。顶层参数写错同样抛错,并把合法值列给你:
await window.afs.exec('/dev/ai/usage/.actions/query',
                      { groupBy: ['day'], filter: { caller: 'todo' } })
// → AFS_VALIDATION_ERROR: unknown argument "filter" —
//    expected one of from | to | groupBy | where | limit | includeCost
这条是 ARC PR #4081 补的:在那之前,{filter: {...}} 会被静默忽略,查询返回整本未过滤的账——一个静默失效的过滤器给出的数字看起来是合理的。如果你对接的是 08-15 之前的 build,where 这个词要自己拼对。
一个例外要知道:_scope_afs 是运行时在派发前盖上去的对象能力(WS seam、AUP 自动派发、chat、scheduler 四处都盖),它按精确名豁免,不算未知参数(ARC #4169)。写错一个字母的 _scope_af 照样报错。你自己在服务端做派发时,这个键可以原样透传。
两条上限要在设计时留出余量:单次查询最多读 5,000 条审计记录(超过时结果带 truncated: true 和告警,绝不悄悄给一个短答案);单张图最多 8 条 series(超出的被丢弃并在 warnings 里点名,绝不并进「其他」桶)和 60 个标签点。
已知边界(核验过的,不是推测的)
以下都是页首那个 build 的当前行为,逐条走出来的。
两个面对同一个人在同一个应用里的消耗,可能给出不同数字。 它们读的是两本账:/usage 读你 DID Space 里的记录,/usage/admin 读应用实例自己的账本。本次(08-20)重走里,todo 在个人面是 53 次调用 / 246,409 tokens,在管理面(同一个用户,且只有这一个用户)是 46 次 / 215,415 tokens;observability-explorer 则反过来(个人面 5 次,管理面 6 次)。五天前那一轮是 48 / 41 与 4 / 5——偏差跟着新数据一起长,不是一次性的历史残留。这不是四舍五入的差异——缺失的记录集中在最早的几天,而写入时没带 userDid 的记录根本进不了按用户视图。把每个面当作它自己那个问题的权威,不要拿一个减另一个。跟踪于 ARC #4082。
(unknown) 是一个真实的桶,不是某个用户。 记录里没有 userDid 的调用照样计入总量,并落在 (unknown) 行。所以一个应用可以同时显示 56 次调用和 0 位活跃用户——上面 discuss-kit 的截图就是这样。它的意思是「没有可归因的人」,不是「没有人调用」。
table-by-instance 在大多数部署上与 table-by-caller 完全重复。 只有当宿主提供了独立的实例身份时,instanceDid 才与 caller 分叉;今天在 afsd.dev 上两者都是 blocklet id,所以两张表逐字节相同。页面刻意只绑其中一张。
任何地方都没有金额。 每个面统计的都是 token。成本估算只存在于 exec … {includeCost: true} 之后,且只在 hub 发布了挂牌价的地方;没有任何页面把 token 折算成货币,它们都不是账单。
登录不等于管理员。 「我管的应用 →」按钮和整个 /usage/admin 面是按应用逐个鉴权的(同实例 admin/owner 或 membership)。如果你能登录却看不到管理面,说明你在这个部署上不管任何应用——页面无法告诉你谁管。
同一条规则在 08-18 之后才覆盖 trace 面。 在那之前,authorizedView 把任意一个应用的 owner/admin 角色映射成部署级权限,于是「某个 app 的 owner」能读到全部署的 agent run(含任务原文),而同一个调用者在这张 usage 管理面上却会被逐实例拒绝——两个面对同一个人给出两种答案。修在 ARC #4170 / PR #4269,判定谓词收敛到 @aigne/afs 里一份。trace 面今天的可见范围见读 agent 运行看板。
会碰到的失败态
| 现象 | 它实际上是什么 |
|---|---|
| "Sign in to view this content." | 不是错误——用量面没有匿名投影 |
| 趋势轴上缺一天 | 那天没有调用;无记录的日期被略过,不填 0 |
缓存列里的 — | 该来源没有上报缓存数据。不是 0% 命中率 |
| 管理面下方明细换了个应用 | 它跟随「最近有用量」;要稳定链接就用 /usage/admin/<instanceDid> |
分享出去的 /usage/admin/<app> 显示「暂无可显示的用量」 | 应用不存在、已下线,或你无权查看——空态不区分这三种 |
查询报 unknown argument "…" | 顶层参数名写错了(filter / wehre…),错误信息里就是合法值清单 |
| 带过滤的查询返回的总量大得可疑 | 你对接的是 ARC #4081 之前的 build,它会忽略写错的顶层参数;拿 scanned 和 totals.calls 对一下 |
延伸阅读
- Search and query ——
list、query、search在 AFS 里的分工 - Reference applications ——
blocklets/下其他有边界的实例